
i14 optimise son modèle Laplace 3B sur AWS Trainium2 avec PyTorch pour une attention linéaire ultra-efficace
Le laboratoire i14 a optimisé son modèle Laplace 3B pour fonctionner sur les processeurs AWS Trainium2, en remplaçant les noyaux Triton par des opérateurs PyTorch natifs. Cette adaptation permet une attention linéaire plus efficace, avec un état récurrent fixe de 29,5 Mo par séquence, indépendant de la longueur du contexte. Les performances atteignent 120 000 tokens/seconde en training et 11 544 tokens/seconde en serving sur une instance trn2.48xlarge.
par Rédaction Lawing Tech (4 min de lecture)
Un modèle à attention linéaire conçu pour contourner les limites du KV cache
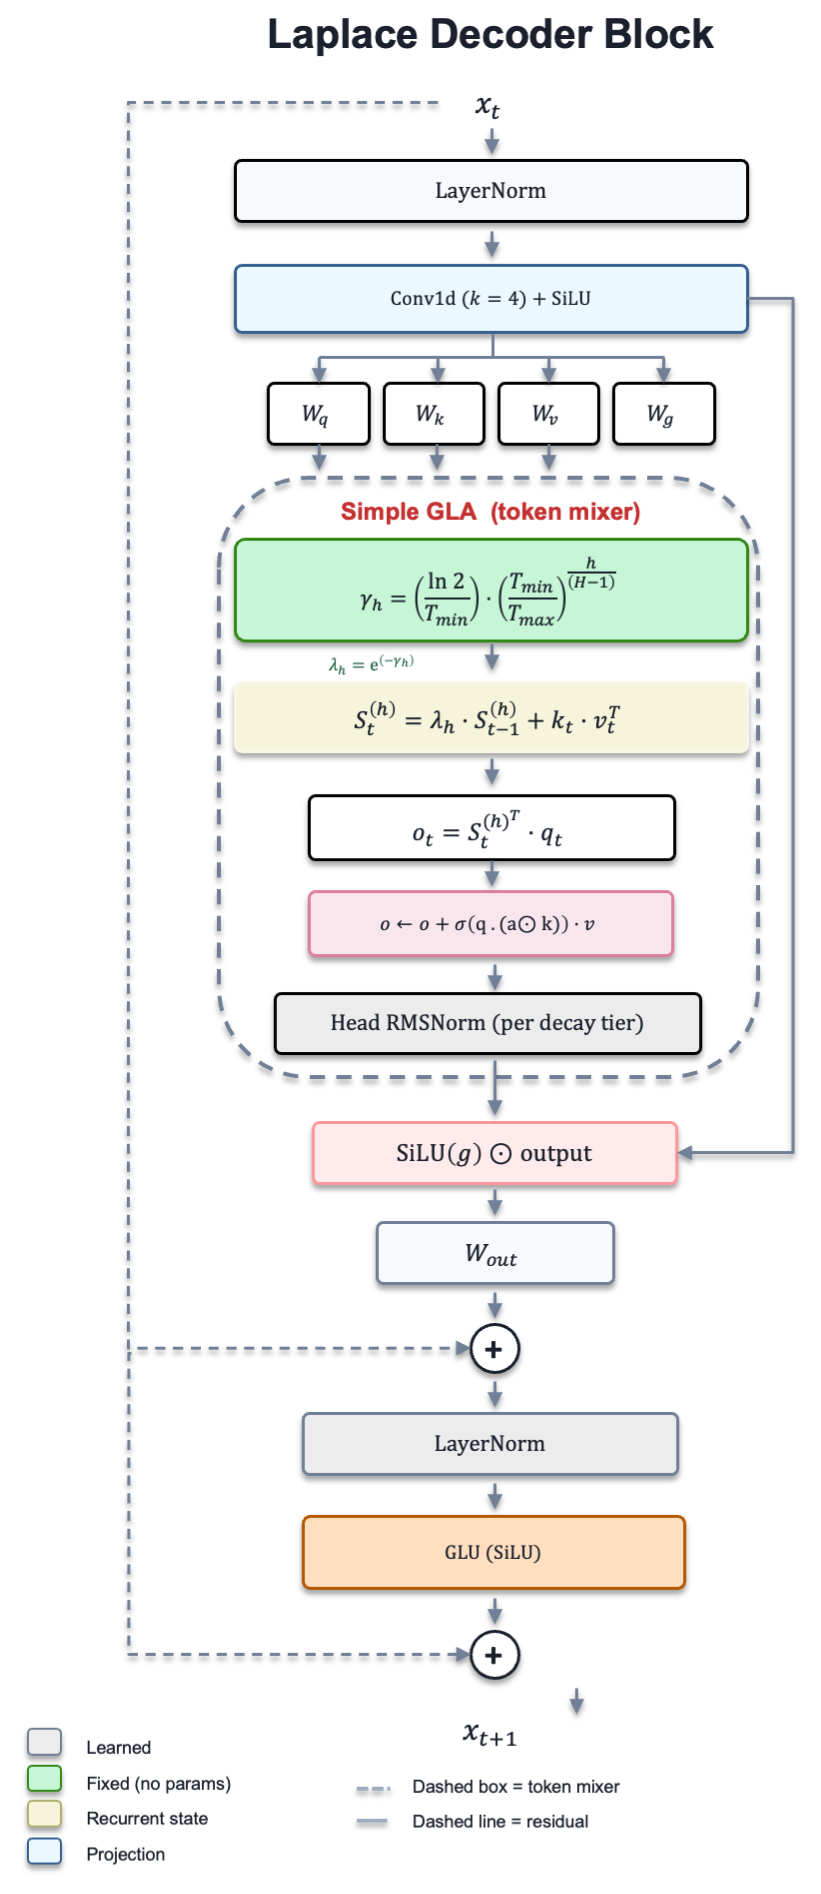
Le modèle Laplace 3B, développé par le laboratoire i14, repose sur une architecture d’attention linéaire plutôt que sur le mécanisme classique de softmax attention utilisé par la majorité des grands modèles de langage (LLM). Contrairement aux architectures transformers traditionnelles, dont la mémoire clé-valeur (KV cache) croît avec la longueur du contexte, Laplace 3B maintient un état récurrent fixe de 29,5 Mo par séquence, indépendamment de la taille du texte traité. Cette approche, basée sur le Gated Linear Attention (GLA), compresse l’historique des données dans une matrice de taille constante, réduisant ainsi la complexité computationnelle de l’attention de O(T²) à O(T), selon les explications fournies par le blog AWS Machine Learning.
Cette innovation répond à un défi majeur des modèles actuels : la gestion des contextes longs. En éliminant la dépendance à un KV cache extensible, Laplace 3B ouvre la voie à des applications nécessitant une mémoire persistante et prévisible, comme les agents conversationnels à long terme ou l’analyse de documents volumineux, où les exigences de serving sont stables et prévisibles.
L’attention linéaire de Laplace 3B compresse l’historique dans un état récurrent fixe, éliminant la dépendance à un KV cache extensible et ouvrant la voie à des applications nécessitant une mémoire persistante et prévisible.
Une collaboration entre i14 et AWS pour une implémentation native sur Trainium2
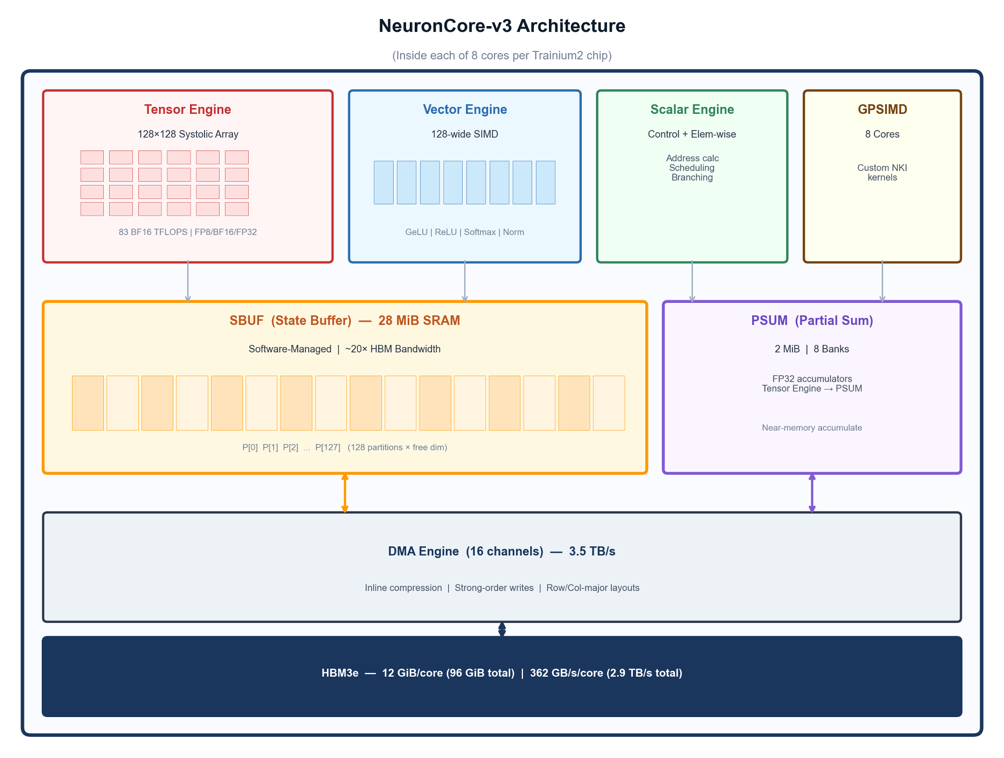
Pour exploiter pleinement les capacités du processeur AWS Trainium2, i14 et AWS ont collaboré à une refonte complète de l’implémentation de Laplace 3B. Le modèle, initialement optimisé pour les GPU avec des noyaux Triton spécifiques, a été réécrit en utilisant des opérateurs PyTorch standard, compatibles avec le support natif de PyTorch sur Trainium2 via TorchNeuron Native. Cette adaptation a permis de tirer parti des spécificités matérielles du processeur, notamment son mémoire sur puce gérée par logiciel (SBUF), composée de 128 partitions de 28 MiB chacune, ainsi que son Tensor Engine 128×128.
Les optimisations incluent une déroulage statique de la récurrence GLA sur 16 étapes, nécessaire pour respecter les contraintes de taille de graphe et de mémoire sur puce de Trainium2. De plus, l’optimiseur MuonFSDP2 a été utilisé pour réduire le trafic de communication inter-processeurs de 24 fois, tout en augmentant le débit de traitement de 1,63 fois, comme détaillé dans les performances mesurées sur une instance trn2.48xlarge (16 puces Trainium2).
Des performances record en training et en serving sur une seule instance
Les résultats obtenus sur l’instance trn2.48xlarge sont significatifs : Laplace 3B atteint un débit de 120 000 tokens/seconde en training et un débit de 11 544 tokens de sortie/seconde en serving, tout en gérant jusqu’à 1 280 séquences concurrentes. Ces chiffres illustrent l’efficacité de l’architecture optimisée pour les workloads exigeants, où la latence et la scalabilité sont critiques.
L’utilisation de l’optimiseur Muon, combinée à des taux de décroissance géométrique à demi-vie variable (de 1 à 2 048 tokens), permet une gestion dynamique de l’attention sur les longues séquences. Cette flexibilité renforce l’adaptabilité du modèle à des cas d’usage variés, tout en maintenant une consommation mémoire maîtrisée.
Ce que cela change ici pour les entreprises et administrations d’Afrique de l’Ouest
Pour les organisations béninoises ou ouest-africaines travaillant sur des projets nécessitant des modèles linguistiques performants avec des contextes longs, comme l’analyse de documents juridiques ou administratifs, ou le développement d’assistants virtuels pour le service client, cette avancée pourrait offrir des solutions plus économiques et scalables. L’indépendance à un KV cache extensible réduirait les coûts liés à l’infrastructure, notamment pour les administrations devant traiter des volumes importants de données textuelles sans investir dans des serveurs haut de gamme.
Les entreprises locales spécialisées en traitement automatique des langues ou en data science pourraient aussi s’appuyer sur des architectures comme Laplace 3B pour déployer des modèles légers mais puissants, adaptés aux contraintes de bande passante et de puissance de calcul souvent limitées en Afrique de l’Ouest. Cependant, l’adoption dépendrait de la disponibilité des instances AWS Trainium2 dans la région, ainsi que de la capacité des équipes techniques à intégrer des outils comme PyTorch et TorchNeuron dans leurs pipelines existants.
Enfin, pour les acteurs publics comme le gouvernement béninois ou les institutions régionales, cette technologie pourrait inspirer des initiatives visant à moderniser les systèmes de gestion documentaire ou à améliorer l’accès aux services numériques, à condition que les coûts d’hébergement sur des infrastructures cloud avancées restent abordables et alignés sur les budgets locaux.
Sources
- Beyond the KV cache: Training and serving i14’s Laplace 3B linear attention model on AWS Trainium2 with native PyTorchAmazon Web Services, 20 octobre 2026
- Training linear-attention Laplace 3B on AWS…AGI Hunt, 20 octobre 2026
Préparé par la veille de Lawing Tech à partir des sources citées. Notre charte éditoriale