
Databricks lance le mode temps réel pour ses pipelines Spark : une révolution pour le traitement des données en millisecondes
Databricks a franchi une étape majeure en rendant disponible en version générale son Real-Time Mode (RTM) pour Spark Declarative Pipelines (SDP), permettant des latences de traitement end-to-end dans la plage des millisecondes. Cette innovation élimine le besoin d’outils spécialisés comme Apache Flink pour les pipelines opérationnels critiques, tout en intégrant des fonctionnalités avancées comme la reprise après échec et la gestion des dépendances.
par Rédaction Lawing Tech (3 min de lecture)
Unification du traitement des données sous Spark : fin des silos techniques
Databricks annonce la disponibilité générale de Real-Time Mode (RTM) pour ses Spark Declarative Pipelines (SDP), une évolution majeure qui unifie le traitement par lots, l’ETL et le streaming à faible latence au sein d’un seul framework : Apache Spark. Selon Databricks, cette intégration élimine le besoin d’utiliser des moteurs spécialisés comme Apache Flink pour les cas d’usage opérationnels en temps réel. RTM est présenté comme une évolution du moteur Spark Structured Streaming, offrant désormais des performances comparables, voire supérieures, à celles des solutions dédiées.
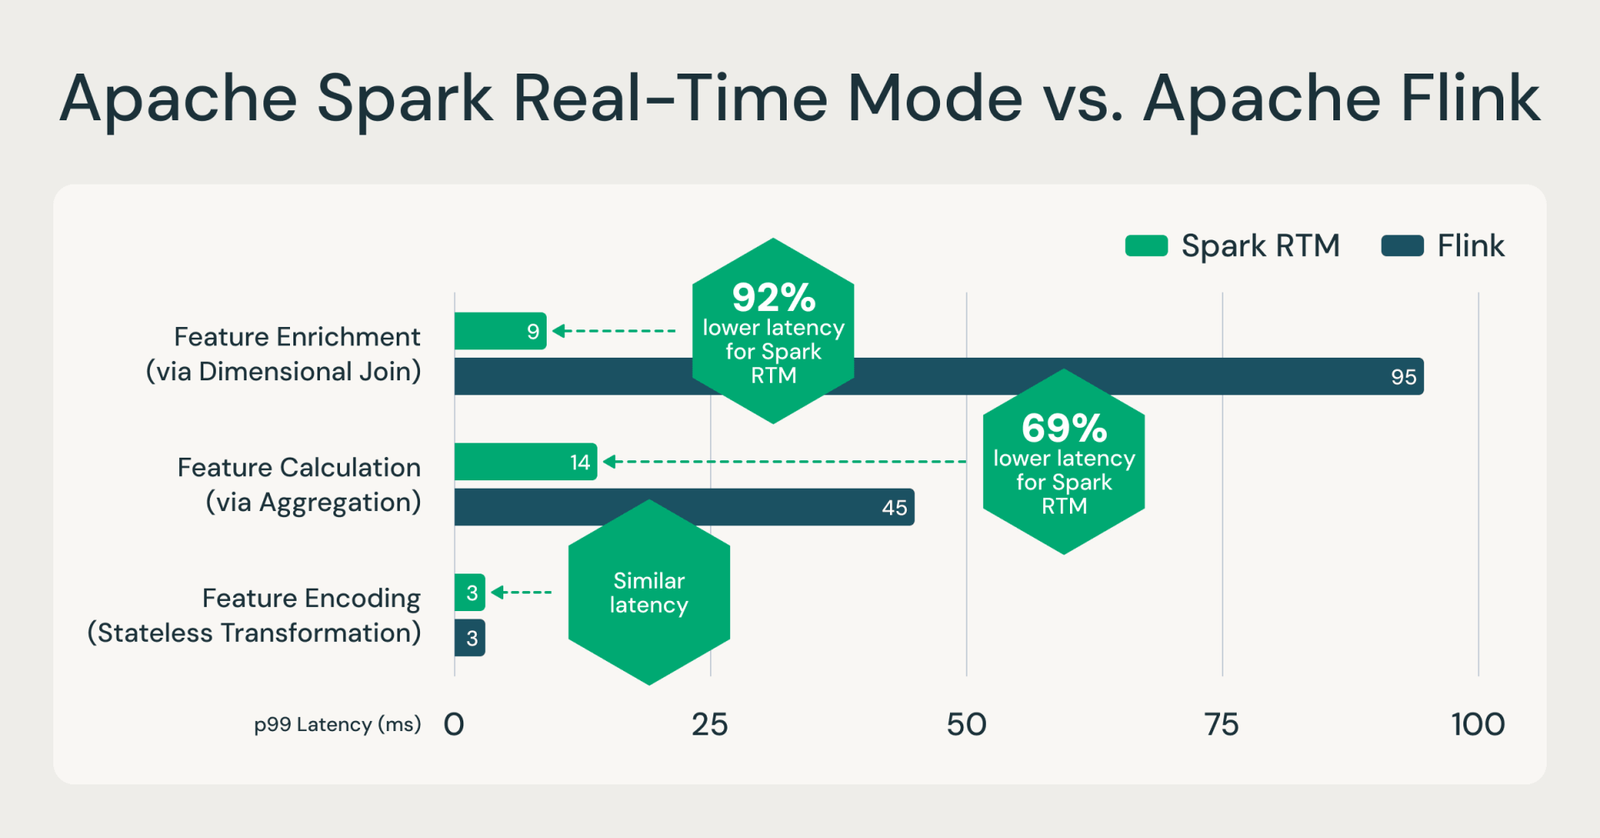
L’annonce souligne que RTM permet des latences end-to-end de l’ordre de la milliseconde pour les charges de travail de streaming opérationnelles. Databricks cite même une amélioration de jusqu’à 92 % de vitesse par rapport à des moteurs comme Flink, tout en maintenant les avantages des pipelines déclaratifs (SDP), tels que la gestion automatique des dépendances, le traitement incrémental ou la reprise après échec.
Real-Time Mode élimine le besoin de moteurs spécialisés comme Apache Flink tout en offrant des latences end-to-end dans la plage des millisecondes, une première pour les pipelines Spark.
Des performances critiques pour des cas d’usage exigeants : fraude, alertes et fonctionnalités en temps réel
RTM sur SDP cible des scénarios où la réactivité est cruciale. Databricks illustre son potentiel avec des applications comme la détection de fraude, les alertes en temps réel ou la mise à jour instantanée de fonctionnalités dans des magasins opérationnels. Par exemple, le Databricks Feature Store utilise cette architecture pour atteindre une latence p99 de 200 millisecondes depuis Kafka jusqu’au magasin de fonctionnalités en ligne, un niveau de performance rare dans les environnements critiques.
Une autre innovation réside dans la capacité à écrire des fonctionnalités directement dans des magasins opérationnels comme Lakebase ou Redis, via des puits ForEach. Cela permet des mises à jour sans version et une maintenance à faible temps d’arrêt, des atouts pour les systèmes nécessitant une disponibilité permanente.
Ce que cela change ici : opportunités pour les entreprises béninoises et ouest-africaines exigeant de la réactivité
Pour les entreprises et administrations du Bénin et d’Afrique de l’Ouest, où les enjeux de cybersécurité, de gestion des transactions financières ou de surveillance des infrastructures critiques se multiplient, cette avancée pourrait transformer la manière de traiter les données en temps réel. Par exemple, les institutions financières pourraient renforcer leurs systèmes de détection de fraude en réduisant les délais d’analyse à quelques millisecondes, limitant ainsi les pertes liées aux transactions suspectes.
Les opérateurs de télécommunications ou les plateformes de paiement mobile, confrontés à des volumes massifs de transactions, pourraient optimiser leurs pipelines de traitement sans recourir à des stacks techniques complexes. De même, les administrations publiques, dans leur quête de services publics plus réactifs (comme la gestion des identités numériques ou la surveillance des réseaux électriques), pourraient bénéficier de latences réduites pour des alertes ou des mises à jour en temps réel.
Enfin, l’intégration native avec des outils comme Redis ou Lakebase pourrait simplifier l’architecture des systèmes locaux, réduisant les coûts de maintenance et les temps d’arrêt. Cependant, son adoption dépendra de la maturité des infrastructures cloud et de la formation des équipes techniques sur les pipelines déclaratifs et les bonnes pratiques de Spark.
Une architecture qui simplifie sans sacrifier les performances
L’un des atouts majeurs de RTM réside dans sa capacité à simplifier les architectures tout en maintenant des performances élevées. SDP gère automatiquement des tâches complexes comme la résolution des dépendances entre pipelines, l’application des règles de qualité des données ou l’orchestration des workflows. Cela réduit la charge de travail des équipes techniques, qui n’ont plus à configurer manuellement des outils comme Flink pour des latences critiques.
Databricks souligne que RTM a été testé par des clients l’année dernière, leur permettant de traiter des données en streaming jusqu’à 100 fois plus rapidement que les architectures micro-batch traditionnelles. Cette évolutivité pourrait être particulièrement utile pour les entreprises ouest-africaines dont les volumes de données explosent avec la digitalisation accélérée (banque mobile, e-commerce, IoT industriel).
Sources
- Announcing General Availability of Real-Time Mode for Spark Declarative Pipelines on DatabricksDatabricks, 29 octobre 2026
Préparé par la veille de Lawing Tech à partir des sources citées. Notre charte éditoriale